Obiettivo
Questa vignetta descrive il flusso di lavoro di ccnlcob
per analizzare un dataset di Comunicazioni Obbligatorie (COB) a livello
di rapporto di lavoro per contratto collettivo nazionale (CCNL). Il
flusso risponde a quattro domande: quali CCNL sono più rilevanti
(persone avviate e giornate di lavoro), come si distribuiscono per CPI
(Centro per l’Impiego), come si distribuiscono per tipologia
contrattuale e come evolve la retribuzione mediana dichiarata
all’avviamento.
Nella versione 0.3.0 sono operative le prime due fasi del flusso:
validazione del contratto dati, preparazione dei rapporti, calcolo delle
giornate di contratto, ranking e selezione dei CCNL rilevanti (Fase 1),
distribuzione territoriale per CPI e distribuzione per tipologia
contrattuale (Fase 2), oltre al perimetro contrattuale applicato in
ingresso da prepare_rapporti() tramite
filter_perimetro(). I blocchi di codice di queste sezioni
vengono eseguiti sul dataset sintetico cob_esempio incluso
nel pacchetto, con il lookup comune -> CPI cpi_esempio.
Le funzioni delle fasi successive (retribuzioni, giornate effettive,
orchestrazione, lettura dei dati) sono documentate con la firma
definitiva ma restituiscono un errore esplicito; i relativi blocchi sono
raccolti nella sezione finale e non vengono eseguiti.
library(ccnlcob)
library(data.table)
#>
#> Attaching package: 'data.table'
#> The following object is masked from 'package:base':
#>
#>     %notin%
1. Validazione del contratto dati
validate_rapporti() verifica che il dataset sia un
data.table e che contenga le colonne del contratto dati. Il
blocco base (id, cf,
inizio, fine,
cod_tipologia_contrattuale, prior e almeno una
colonna CCNL fra codice_cnel, ccnl e
ccnl_warehouse) è sempre controllato; i blocchi
cpi, retribuzione e datore
vengono verificati solo se richiesti. La funzione non modifica il
dataset e, se il controllo passa, lo restituisce invisibilmente.
Il dataset sintetico cob_esempio riproduce il contratto
dati con sovrapposizioni fra rapporti della stessa persona, sentinelle
sulle date di fine, codici CNEL mancanti per una quota di rapporti e
retribuzioni mancanti o anomale.
dt <- copy(cob_esempio)
validate_rapporti(dt)
validate_rapporti(dt, require = c("cpi", "retribuzione", "datore"))
str(dt)
#> Classes 'data.table' and 'data.frame':   5000 obs. of  18 variables:
#>  $ id                        : int  1 2 3 4 5 6 7 8 9 10 ...
#>  $ cf                        : chr  "CF00001" "CF00002" "CF00003" "CF00004" ...
#>  $ inizio                    : Date, format: "2024-08-18" "2024-02-05" ...
#>  $ fine                      : Date, format: "2024-12-09" "2024-04-28" ...
#>  $ codice_cnel               : chr  "Q011" "D011" "E011" "B011" ...
#>  $ ccnl                      : chr  "2875" "0752" "1729" "1489" ...
#>  $ cod_tipologia_contrattuale: chr  "A.06.01" "A.05.02" "A.02.00" "A.06.01" ...
#>  $ prior                     : int  0 0 1 1 1 1 1 1 1 1 ...
#>  $ comune_sede_lavoro        : chr  "L682" "C933" "B157" "E507" ...
#>  $ comune_lavoratore         : chr  "F205" "A794" "F704" "F205" ...
#>  $ datore                    : chr  "DAT00517" "DAT00164" "DAT00478" "DAT00564" ...
#>  $ retribuzione              : num  NA 8645 NA 10776 NA ...
#>  $ ore                       : num  17 20 38 36 40 40 40 36 36 40 ...
#>  $ troncata                  : int  0 0 0 0 0 0 1 0 0 0 ...
#>  $ qualifica                 : chr  "253" "541" "712" "813" ...
#>  $ ateco_gruppo              : chr  "41.2" "10.7" "43.3" "81.2" ...
#>  $ eta                       : int  40 47 49 27 27 51 56 56 59 22 ...
#>  $ sesso                     : chr  "F" "F" "M" "F" ...
#>  - attr(*, ".internal.selfref")=<pointer: 0x5577531f5f00>
2. Preparazione
prepare_rapporti() lavora su una copia e restituisce un
nuovo data.table. In sequenza:
- rinomina le varianti maiuscole prodotte dalla pipeline COB e la
colonna sorgente
ccnl(codice warehouse) inccnl_warehouse; - applica il perimetro contrattuale (argomento
perimetro, default"ccnl") tramitefilter_perimetro(), escludendo le tipologie alle quali non si applica un CCNL (vedi il paragrafo seguente); - sceglie la chiave di analisi
ccnl_key: per defaultcodice_cnelse presente, altrimenticcnl_warehouse; - risolve le sentinelle sulle date. Una
finemancante, non successiva a1900-01-01o successiva adas_of(incluso9999-12-31) identifica un rapporto aperto: la data viene sostituita conas_ofetroncatavale 1. Uniniziomancante o non successivo a1900-01-01viene portato al2008-03-01(avvio del sistema COB) controncata_iniziopari a 1. Dopo le sostituzioni, un rapporto confine < inizioviene riportato a un giorno; - rimuove i rapporti che non intersecano la finestra
windowe conta le giornate di contratto interne alla finestra; - aggiunge le colonne derivate
avviato,attivo,anno,trimestre,macro_tipologiaeorario.
Se as_of è NULL viene usata la data massima
non sentinella osservata fra inizio e fine; se
window è NULL la finestra va dal primo
avviamento non sentinella ad as_of. Nell’esempio entrambi i
parametri sono espliciti: la finestra copre il triennio 2022-2024 e lo
stato dei rapporti è valutato al 31 dicembre 2024.
Perimetro contrattuale
Non tutti gli avviamenti registrati nelle Comunicazioni Obbligatorie
sono rapporti di lavoro subordinato ai quali si applica un contratto
collettivo. Restano fuori le collaborazioni e il lavoro occasionale
(codici MLPS B.), i tirocini, i lavori socialmente utili e
le work experience (C.), il lavoro autonomo nello
spettacolo (G.03.00), il lavoro congiunto in agricoltura
(H.02.00), l’associazione in partecipazione
(L.) e il contratto di agenzia (M.). Includere
questi rapporti nelle classifiche dei CCNL altera le misure di
rilevanza: le giornate e le persone attribuite a un CCNL
comprenderebbero rapporti che quel contratto non regola. Per questo
prepare_rapporti() applica per default il perimetro
"ccnl", definito dal flag perimetro_ccnl del
lookup tipologie_contrattuali, prima di ogni altro
trattamento. I codici assenti dal lookup sono trattati come fuori
perimetro e conteggiati a parte.
L’esclusione non è mai silenziosa: filter_perimetro()
emette un messaggio riassuntivo, riportato di seguito una sola volta, e
i conteggi restano nei metadati.
dt <- prepare_rapporti(
  dt,
  as_of = as.Date("2024-12-31"),
  window = as.Date(c("2022-01-01", "2024-12-31")),
  ccnl_key = "codice_cnel"
)
#> filter_perimetro(): perimetro "ccnl", esclusi 254 rapporti su 5000 (5,1%) in 4 tipologie; 0 con tipologia ignota.
I metadati riportano il perimetro applicato, il numero di rapporti
esclusi e la tabella esclusi_perimetro con le righe escluse
per tipologia.
meta <- attr(dt, "ccnlcob_meta")
meta[c("perimetro", "n_input", "n_dropped_perimetro", "n_tipologia_ignota")]
#> $perimetro
#> [1] "ccnl"
#>
#> $n_input
#> [1] 5000
#>
#> $n_dropped_perimetro
#> [1] 254
#>
#> $n_tipologia_ignota
#> [1] 0
knitr::kable(meta$esclusi_perimetro)| cod_tipologia_contrattuale | des_tipologia_contrattuale | macro_tipologia | n |
|---|---|---|---|
| C.01.00 | TIROCINIO | Tirocinio | 110 |
| B.03.00 | COLLABORAZIONE COORDINATA E CONTINUATIVA | Collaborazioni | 90 |
| B.04.00 | COLLABORAZIONE OCCASIONALE SPORTIVA EX ART. 28 DEL D.LGS. 36/2021 | Collaborazioni | 35 |
| C.03.00 | LAVORO O ATTIVITÀ SOCIALMENTE UTILE (LSU - ASU) | Altro | 19 |
Nel dataset di esempio il perimetro esclude 254 rapporti su 5000 in 4 tipologie, con 0 codici ignoti. Sono disponibili tre perimetri:
-
"ccnl"(default): conserva le tipologie conperimetro_ccnl == TRUE; i codici ignoti vengono esclusi; -
"standard": riproduce il perimetro dicnelR, che esclude solo le tipologie conesclusa_standard == TRUEnel lookup; i codici ignoti vengono conservati; -
"completo": non esclude nulla e riproduce il comportamento delle versioni fino alla 0.2.0. La colonna logicaperimetro_ccnlresta disponibile per distinguere i rapporti.
Il filtro può essere applicato anche al dato grezzo con
filter_perimetro(), che restituisce un nuovo
data.table con la colonna perimetro_ccnl e
l’attributo ccnlcob_perimetro; l’input non viene
modificato.
std <- filter_perimetro(cob_esempio, perimetro = "standard")
attr(std, "ccnlcob_perimetro")[c("perimetro", "n_input", "n_kept", "n_dropped")]
#> $perimetro
#> [1] "standard"
#>
#> $n_input
#> [1] 5000
#>
#> $n_kept
#> [1] 4765
#>
#> $n_dropped
#> [1] 235
tutto <- filter_perimetro(cob_esempio, perimetro = "completo")
tutto[, .N, by = perimetro_ccnl]
#>    perimetro_ccnl     N
#>            <lgcl> <int>
#> 1:           TRUE  4746
#> 2:          FALSE   254
L’attributo ccnlcob_meta conserva i parametri usati e i
conteggi delle correzioni: rapporti in ingresso, rapporti esclusi dal
perimetro, rapporti esclusi perché esterni alla finestra, sentinelle su
fine e su inizio, intervalli con
fine < inizio.
meta[setdiff(names(meta), "esclusi_perimetro")]
#> $as_of
#> [1] "2024-12-31"
#>
#> $window
#> [1] "2022-01-01" "2024-12-31"
#>
#> $ccnl_key
#> [1] "codice_cnel"
#>
#> $chiavi_non_classificate
#> [1] "CPUB"
#>
#> $perimetro
#> [1] "ccnl"
#>
#> $n_input
#> [1] 5000
#>
#> $n_dropped_perimetro
#> [1] 254
#>
#> $n_tipologia_ignota
#> [1] 0
#>
#> $n_chiavi_non_classificate
#> [1] 56
#>
#> $n_dropped_window
#> [1] 1819
#>
#> $n_sentinel_fine
#> [1] 149
#>
#> $n_sentinel_inizio
#> [1] 0
#>
#> $n_fine_lt_inizio
#> [1] 2
#>
#> $n_retribuzione_non_numerica
#> [1] 0
#>
#> $n_ore_non_numeriche
#> [1] 0
Le colonne aggiunte hanno il seguente significato:
-
perimetro_ccnl(logical): appartenenza al perimetro CCNL secondo il lookup; con il perimetro di default vale sempreTRUE; -
giornate(integer): giorni di contratto compresi nella finestra, estremi inclusi. Un rapporto iniziato prima diwindow[1]o terminato dopowindow[2]conta solo la parte interna alla finestra; poiché i rapporti esterni sono già stati rimossi,giornateè sempre maggiore o uguale a 1; -
avviato(logical):inizio >= window[1], cioè avviamento interno alla finestra. I rapporti iniziati prima della finestra restano nel dataset conavviato = FALSE: contribuiscono alle giornate ma non ai conteggi di avviamenti e persone avviate; -
attivo(logical): rapporto in essere alla dataas_of; -
anno(integer) etrimestre(character,YYYY-Qn): coorte di avviamento calcolata dainizio; -
macro_tipologia(character): macro-classe della tipologia contrattuale,NAper i codici assenti dal lookup; -
orario(character):FTperprior == 1,PTperprior == 0.
knitr::kable(
  dt[1:6, .(
    id, inizio, fine, ccnl_key, giornate, avviato, attivo,
    anno, trimestre, macro_tipologia, orario
  )]
)| id | inizio | fine | ccnl_key | giornate | avviato | attivo | anno | trimestre | macro_tipologia | orario |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 2024-08-18 | 2024-12-09 | Q011 | 114 | TRUE | FALSE | 2024 | 2024-Q3 | Somministrazione | PT |
| 2 | 2024-02-05 | 2024-04-28 | D011 | 84 | TRUE | FALSE | 2024 | 2024-Q1 | Intermittente | PT |
| 6 | 2023-07-03 | 2023-08-15 | H011 | 44 | TRUE | FALSE | 2023 | 2023-Q3 | Tempo determinato | FT |
| 7 | 2024-03-20 | 2024-12-31 | A011 | 287 | TRUE | TRUE | 2024 | 2024-Q1 | Tempo indeterminato | FT |
| 8 | 2020-02-10 | 2023-07-22 | B011 | 568 | FALSE | FALSE | 2020 | 2020-Q1 | Tempo determinato | FT |
| 10 | 2023-07-01 | 2024-02-02 | IC91 | 217 | TRUE | FALSE | 2023 | 2023-Q3 | Tempo determinato | FT |
dt[, .(rapporti = .N, giornate = sum(giornate)), by = avviato]
#>    avviato rapporti giornate
#>     <lgcl>    <int>    <int>
#> 1:    TRUE     2436   434922
#> 2:   FALSE      491   188754
La macro-tipologia deriva dal lookup
tipologie_contrattuali, incluso nel pacchetto, tramite
classify_tipologia(). La funzione è vettorizzata, conserva
ordine e lunghezza dell’input e restituisce NA per i codici
ignoti.
classify_tipologia(c("A.01.00", "A.02.00", "A.03.00", "C.01.00", "ZZZ", NA))
#> [1] "Tempo indeterminato" "Tempo determinato"   "Apprendistato"
#> [4] "Tirocinio"           NA                    NA
dt[, .N, by = .(macro_tipologia, orario)][order(-N)]
#>         macro_tipologia orario     N
#>                  <char> <char> <int>
#>  1:   Tempo determinato     FT   808
#>  2: Tempo indeterminato     FT   635
#>  3:   Tempo determinato     PT   311
#>  4:    Somministrazione     FT   277
#>  5: Tempo indeterminato     PT   232
#>  6:       Apprendistato     FT   173
#>  7:       Intermittente     PT   167
#>  8:    Somministrazione     PT   111
#>  9:       Intermittente     FT    93
#> 10:       Apprendistato     PT    63
#> 11:           Domestico     PT    31
#> 12:           Domestico     FT    26
3. Giornate di contratto
compute_giornate() è la funzione richiamata da
prepare_rapporti() per calcolare giornate. Per
ogni rapporto
giornate = max(0, min(fine, window[2]) - max(inizio, window[1]) + 1)con window = NULL la misura coincide con l’intera durata
del rapporto. La colonna è di tipo integer e viene aggiunta per
riferimento, quindi la funzione modifica il data.table
passato come argomento. La misura è additiva: ogni rapporto conta per
intero e le sovrapposizioni fra rapporti della stessa persona non
vengono corrette. La correzione pro quota è demandata a
compute_giornate_effettive(), prevista nella Fase 4.
La funzione può essere richiamata direttamente per ricalcolare le giornate su una finestra diversa da quella di preparazione, per esempio il solo anno 2024. I rapporti che non intersecano la nuova finestra ricevono zero giornate e restano nel dataset.
dt24 <- copy(dt)
compute_giornate(dt24, window = as.Date(c("2024-01-01", "2024-12-31")))
dt24[, .(rapporti = .N, giornate = sum(giornate)), by = .(nel_2024 = giornate > 0)]
#>    nel_2024 rapporti giornate
#>      <lgcl>    <int>    <int>
#> 1:     TRUE     1393   221212
#> 2:    FALSE     1534        0
4. Ranking dei CCNL
rank_ccnl() calcola, per ciascun valore di
ccnl_key, le misure di rilevanza richieste e, per ognuna,
la quota sul totale (quota_<misura>), il rank in
ordine decrescente (rank_<misura>) e la quota
cumulata lungo il rank (quota_cum_<misura>). Le
misure disponibili sono n_rapporti,
n_lavoratori, n_datori, giornate,
giornate_effettive e stock; le prime tre
contano solo i rapporti con avviato = TRUE,
stock conta i rapporti con attivo = TRUE. Non
viene costruito alcun indice composito: ogni misura produce il proprio
ordinamento e la prima misura in measures determina
l’ordine delle righe.
I rapporti con ccnl_key mancante non vengono scartati:
formano la riga Non classificati, con classe
dedicata, rank NA e quota cumulata NA. Le
quote di tutte le righe sono calcolate sul totale che include questa
riga, così che sommino a 1 e la copertura del codice CCNL resti visibile
direttamente nella tabella.
ranking <- rank_ccnl(dt, measures = c("n_lavoratori", "giornate"))
names(ranking)
#>  [1] "ccnl_key"               "classe"                 "n_lavoratori"
#>  [4] "quota_n_lavoratori"     "rank_n_lavoratori"      "quota_cum_n_lavoratori"
#>  [7] "giornate"               "quota_giornate"         "rank_giornate"
#> [10] "quota_cum_giornate"
knitr::kable(
  ranking[1:10, .(
    ccnl_key, n_lavoratori, quota_n_lavoratori, rank_n_lavoratori,
    giornate, quota_giornate, rank_giornate, quota_cum_giornate
  )],
  digits = 3
)| ccnl_key | n_lavoratori | quota_n_lavoratori | rank_n_lavoratori | giornate | quota_giornate | rank_giornate | quota_cum_giornate |
|---|---|---|---|---|---|---|---|
| A011 | 218 | 0.125 | 1 | 118854 | 0.191 | 1 | 0.191 |
| H011 | 167 | 0.096 | 2 | 62233 | 0.100 | 2 | 0.290 |
| T011 | 136 | 0.078 | 3 | 49468 | 0.079 | 3 | 0.370 |
| C011 | 110 | 0.063 | 4 | 31713 | 0.051 | 4 | 0.421 |
| IC91 | 86 | 0.049 | 5 | 29904 | 0.048 | 5 | 0.468 |
| A012 | 78 | 0.045 | 6 | 23667 | 0.038 | 6 | 0.506 |
| B011 | 62 | 0.035 | 7 | 18770 | 0.030 | 7 | 0.537 |
| F011 | 61 | 0.035 | 8 | 17180 | 0.028 | 10 | 0.621 |
| D011 | 57 | 0.033 | 9 | 17326 | 0.028 | 9 | 0.593 |
| E011 | 57 | 0.033 | 9 | 18163 | 0.029 | 8 | 0.566 |
La riga dei non classificati chiude la tabella; la sua quota misura la parte del fenomeno che il raccordo dei codici CCNL non copre.
knitr::kable(
  ranking[, .(giornate = sum(giornate), quota = sum(quota_giornate)), by = classe],
  digits = 3
)| classe | giornate | quota |
|---|---|---|
| CCNL | 516543 | 0.828 |
| Non classificati | 107133 | 0.172 |
Con l’argomento periodo il ranking è calcolato entro
ciascuna coorte di avviamento (anno o
trimestre): quote, rank e quote cumulate sono ricalcolati
per gruppo. L’argomento by permette di aggiungere altre
colonne di raggruppamento, per esempio macro_tipologia.
per_anno <- rank_ccnl(dt, measures = "giornate", periodo = "anno")
knitr::kable(per_anno[rank_giornate <= 3L], digits = 3)| anno | ccnl_key | classe | giornate | quota_giornate | rank_giornate | quota_cum_giornate |
|---|---|---|---|---|---|---|
| 2019 | T011 | CCNL | 5376 | 0.134 | 1 | 0.134 |
| 2019 | A011 | CCNL | 3526 | 0.088 | 2 | 0.221 |
| 2019 | B011 | CCNL | 3288 | 0.082 | 3 | 0.303 |
| 2020 | A011 | CCNL | 9381 | 0.207 | 1 | 0.207 |
| 2020 | H011 | CCNL | 7067 | 0.156 | 2 | 0.363 |
| 2020 | T011 | CCNL | 3710 | 0.082 | 3 | 0.445 |
| 2021 | A011 | CCNL | 23180 | 0.225 | 1 | 0.225 |
| 2021 | H011 | CCNL | 8520 | 0.083 | 2 | 0.307 |
| 2021 | C011 | CCNL | 7000 | 0.068 | 3 | 0.375 |
| 2022 | A011 | CCNL | 37331 | 0.194 | 1 | 0.194 |
| 2022 | H011 | CCNL | 17774 | 0.092 | 2 | 0.286 |
| 2022 | T011 | CCNL | 16098 | 0.084 | 3 | 0.370 |
| 2023 | A011 | CCNL | 28729 | 0.185 | 1 | 0.185 |
| 2023 | H011 | CCNL | 17288 | 0.112 | 2 | 0.297 |
| 2023 | T011 | CCNL | 11990 | 0.077 | 3 | 0.374 |
| 2024 | A011 | CCNL | 16707 | 0.191 | 1 | 0.191 |
| 2024 | H011 | CCNL | 9324 | 0.107 | 2 | 0.298 |
| 2024 | T011 | CCNL | 8060 | 0.092 | 3 | 0.390 |
5. Selezione dei CCNL rilevanti
select_ccnl_rilevanti() individua, entro ogni gruppo del
ranking, i CCNL che coprono una quota cumulata della misura scelta
(cum_share) e/o i primi top_n. La selezione
scorre i CCNL classificati in ordine di rank e include un CCNL finché la
quota cumulata dei precedenti è inferiore alla soglia: è quindi
l’insieme minimo con copertura maggiore o uguale a
cum_share. Se entrambi i criteri sono forniti prevale il
più restrittivo. Il pacchetto non fissa soglie a priori: i due parametri
sono espliciti.
Le quote usate sono quelle del ranking, calcolate sul totale del
gruppo inclusi i non classificati. Una soglia
cum_share = 0.8 indica quindi l’80% delle giornate totali,
non l’80% delle giornate con codice CCNL noto. Quando la copertura del
codice è inferiore a 1, raggiungere la soglia richiede una quota più
ampia dei CCNL classificati; se la copertura è inferiore alla soglia
stessa, la selezione include tutti i CCNL classificati senza
raggiungerla.
Con return = "keys" (default) la funzione restituisce il
vettore delle chiavi selezionate.
rilevanti <- select_ccnl_rilevanti(ranking, measure = "giornate", cum_share = 0.8)
rilevanti
#>  [1] "A011" "H011" "T011" "C011" "IC91" "A012" "B011" "E011" "D011" "F011"
#> [11] "H012" "M011" "I011" "K011" "G011" "L011" "Q011" "N011" "V011" "P011"
#> [21] "T012"
length(rilevanti)
#> [1] 21
ranking[ccnl_key %in% rilevanti, max(quota_cum_giornate)]
#> [1] 0.802484
Nel dataset di esempio la copertura del codice CNEL è pari a 0.828 delle giornate, per cui la soglia dell’80% del totale seleziona 21 dei 24 CCNL classificati.
Con return = "table" la funzione restituisce il ranking
con la colonna logica selezionato; i CCNL classificati non
selezionati sono aggregati in una riga Altri CCNL
(etichetta modificabile con other_label) con le misure
sommate e le quote ricalcolate sul gruppo, mentre la riga dei non
classificati è conservata. Nell’esempio top_n = 5 si
combina con il default cum_share = 0.8; per usare il solo
top_n occorre impostare cum_share = NULL.
tabella <- select_ccnl_rilevanti(
  ranking,
  measure = "giornate",
  top_n = 5,
  return = "table"
)
knitr::kable(
  tabella[, .(
    ccnl_key, classe, selezionato, n_lavoratori, quota_n_lavoratori,
    giornate, quota_giornate
  )],
  digits = 3
)| ccnl_key | classe | selezionato | n_lavoratori | quota_n_lavoratori | giornate | quota_giornate |
|---|---|---|---|---|---|---|
| A011 | CCNL | TRUE | 218 | 0.125 | 118854 | 0.191 |
| H011 | CCNL | TRUE | 167 | 0.096 | 62233 | 0.100 |
| T011 | CCNL | TRUE | 136 | 0.078 | 49468 | 0.079 |
| C011 | CCNL | TRUE | 110 | 0.063 | 31713 | 0.051 |
| IC91 | CCNL | TRUE | 86 | 0.049 | 29904 | 0.048 |
| Altri CCNL | Altri CCNL | FALSE | 820 | 0.469 | 224371 | 0.360 |
| NA | Non classificati | FALSE | 211 | 0.121 | 107133 | 0.172 |
attr(tabella, "ccnlcob_selezione")[c("measure", "top_n", "cum_share")]
#> $measure
#> [1] "giornate"
#>
#> $top_n
#> [1] 5
#>
#> $cum_share
#> [1] 0.8
Le sezioni seguenti usano i primi cinque CCNL per giornate come
sottoinsieme di lavoro. Con cum_share = NULL la selezione
dipende dal solo top_n.
top5 <- select_ccnl_rilevanti(
  ranking,
  measure = "giornate",
  top_n = 5,
  cum_share = NULL
)
top5
#> [1] "A011" "H011" "T011" "C011" "IC91"
6. Distribuzione territoriale per CPI
add_cpi() associa a ogni rapporto il codice e il nome
del CPI a partire dal codice Belfiore della sede di lavoro
(comune_sede_lavoro, con geo = "sede_lavoro",
default) o della residenza del lavoratore
(comune_lavoratore, con geo = "residenza"). Le
colonne cpi_code e cpi_name vengono aggiunte
per riferimento; l’attributo ccnlcob_cpi registra la
geografia usata e l’origine del mapping.
Il mapping comune -> CPI non è reimplementato nel pacchetto. In
produzione, con lookup = NULL, la funzione delega a
longworkR::add_cpi_via_belfiore(), che legge i file di
mapping dalla directory SHARED_DATA_DIR/maps; il mapping
viene costruito una sola volta sui codici Belfiore distinti e poi
agganciato ai rapporti. In questa vignetta si usa invece il lookup
cpi_esempio incluso nel pacchetto, che copre i dodici
capoluoghi lombardi presenti in cob_esempio. Un lookup
esplicito richiede le colonne belfiore (univoca),
cpi_code e, facoltativa, cpi_name.
Nessun rapporto viene scartato. Un codice Belfiore presente ma
assente dal lookup, tipicamente un comune fuori regione, riceve
cpi_code = "FUORI" e
cpi_name = "Fuori Lombardia"; un codice mancante riceve
cpi_code = "ND" e
cpi_name = "Non disponibile". Nel dataset di esempio i
quattro codici non lombardi confluiscono nella classe FUORI
e nessun codice è mancante.
add_cpi(dt, geo = "sede_lavoro", lookup = cpi_esempio)
attr(dt, "ccnlcob_cpi")
#> $geo
#> [1] "sede_lavoro"
#>
#> $source
#> [1] "lookup"
dt[, .N, by = .(cpi_code, cpi_name)][order(-N)]
#>        cpi_code        cpi_name     N
#>          <char>          <char> <int>
#>  1: F205C000169      CPI MILANO   913
#>  2: L682C000600      CPI VARESE   417
#>  3: B157C000683     CPI BRESCIA   296
#>  4: F704C000581       CPI MONZA   279
#>  5: A794C000060     CPI BERGAMO   230
#>  6: C933C000073        CPI COMO   159
#>  7:       FUORI Fuori Lombardia   140
#>  8: G388C000070       CPI PAVIA   139
#>  9: D150C000030     CPI CREMONA    95
#> 10: E507C000578       CPI LECCO    88
#> 11: E897C000034     CPI MANTOVA    72
#> 12: I829C000043     CPI SONDRIO    52
#> 13: E648C000580        CPI LODI    47
ccnl_by_cpi() calcola la tabella ccnl_key x
CPI per la misura scelta (le stesse di rank_ccnl(), default
giornate). Se dt contiene già
cpi_code, come in questo caso, la colonna viene usata così
com’è e gli argomenti geo e lookup sono
ignorati; altrimenti il CPI viene calcolato con add_cpi()
su una copia delle colonne necessarie, senza modificare dt.
L’argomento ccnl limita l’uscita alle chiavi indicate.
cpi <- ccnl_by_cpi(dt, measure = "giornate", ccnl = top5)
names(cpi)
#> [1] "ccnl_key"      "classe"        "cpi_code"      "cpi_name"
#> [5] "giornate"      "quota_riga"    "quota_colonna" "lq"
knitr::kable(
  cpi[ccnl_key == top5[1], .(cpi_name, giornate, quota_riga, quota_colonna, lq)],
  digits = 3
)| cpi_name | giornate | quota_riga | quota_colonna | lq |
|---|---|---|---|---|
| CPI MILANO | 37334 | 0.314 | 0.186 | 0.974 |
| CPI BRESCIA | 15721 | 0.132 | 0.264 | 1.386 |
| CPI VARESE | 12445 | 0.105 | 0.138 | 0.725 |
| CPI BERGAMO | 10862 | 0.091 | 0.215 | 1.126 |
| CPI MONZA | 9532 | 0.080 | 0.179 | 0.938 |
| CPI PAVIA | 8255 | 0.069 | 0.264 | 1.385 |
| Fuori Lombardia | 8181 | 0.069 | 0.248 | 1.303 |
| CPI COMO | 3545 | 0.030 | 0.113 | 0.593 |
| CPI LODI | 3222 | 0.027 | 0.352 | 1.846 |
| CPI SONDRIO | 2955 | 0.025 | 0.211 | 1.105 |
| CPI MANTOVA | 2839 | 0.024 | 0.211 | 1.107 |
| CPI LECCO | 2473 | 0.021 | 0.134 | 0.704 |
| CPI CREMONA | 1490 | 0.013 | 0.081 | 0.427 |
Per ogni cella (CCNL c, CPI d), detto
v il valore della misura e T il totale, la
tabella riporta tre grandezze:
-
quota_riga = v[c,d] / T[c]: distribuzione territoriale del CCNL fra i CPI; somma a 1 entro ogni CCNL; -
quota_colonna = v[c,d] / T[d]: peso del CCNL all’interno del CPI; somma a 1 entro ogni CPI; -
lq = quota_colonna / (T[c] / T): quoziente di localizzazione, cioè la quota di colonna rapportata alla quota complessiva del CCNL. Un valore maggiore di 1 indica che il CCNL è concentrato nel CPI più della media del gruppo; entro ogni CCNL la media dilqponderata conT[d] / Tè pari a 1.
I totali T[c], T[d] e T sono
calcolati su tutte le righe di dt, inclusi i rapporti con
ccnl_key mancante (riga Non classificati), e
prima del filtro ccnl: le quote dei CCNL conservati non
cambiano filtrando. Il filtro esclude la riga dei non classificati, che
resta in uscita includendo NA in ccnl oppure
con ccnl = NULL. Il quoziente lq è mascherato
con NA nelle celle dei CPI il cui totale T[d]
è inferiore a min_n (default 30 unità della misura); le
celle restano nella tabella. Nel dataset di esempio tutti i CPI superano
la soglia sulle giornate.
cpi[, .(quota_riga = sum(quota_riga), lq_min = min(lq), lq_max = max(lq)), by = ccnl_key]
#>    ccnl_key quota_riga     lq_min   lq_max
#>      <char>      <num>      <num>    <num>
#> 1:     A011          1 0.42668877 1.845559
#> 2:     C011          1 0.35950792 1.722439
#> 3:     H011          1 0.44464003 1.404219
#> 4:     IC91          1 0.01000221 3.397226
#> 5:     T011          1 0.10421043 1.615597
cpi[order(-lq)][1:5, .(ccnl_key, cpi_name, giornate, quota_colonna, lq)]
#>    ccnl_key        cpi_name giornate quota_colonna       lq
#>      <char>          <char>    <num>         <num>    <num>
#> 1:     IC91     CPI SONDRIO     2286    0.16289012 3.397226
#> 2:     A011        CPI LODI     3222    0.35170833 1.845559
#> 3:     IC91       CPI LECCO     1581    0.08576078 1.788622
#> 4:     C011 Fuori Lombardia     2885    0.08758349 1.722439
#> 5:     IC91        CPI COMO     2514    0.08013260 1.671241
Gli argomenti periodo (anno o
trimestre) e by producono la distribuzione
entro ciascuna coorte di avviamento o entro gruppi aggiuntivi, con quote
e quozienti ricalcolati per gruppo; l’attributo
ccnlcob_crosstab riporta misura, dimensioni, soglia e
geografia.
7. Distribuzione per tipologia contrattuale
ccnl_by_tipologia() calcola con la stessa struttura la
tabella ccnl_key x tipologia, per default incrociata anche
con l’orario (FT/PT). Con
level = "macro" la tipologia è la macro-classe di
tipologie_contrattuali, già presente in dt
come macro_tipologia dopo prepare_rapporti();
i codici senza macro-classe formano la tipologia
Non classificata e l’orario mancante la classe
ND. La misura di default è n_rapporti.
tipologie <- ccnl_by_tipologia(
  dt,
  measure = "n_rapporti",
  ccnl = top5,
  level = "macro"
)
names(tipologie)
#> [1] "ccnl_key"      "classe"        "tipologia"     "orario"
#> [5] "n_rapporti"    "quota_riga"    "quota_colonna" "lq"
knitr::kable(
  tipologie[ccnl_key == top5[1], .(tipologia, orario, n_rapporti, quota_riga, lq)],
  digits = 3
)| tipologia | orario | n_rapporti | quota_riga | lq |
|---|---|---|---|---|
| Tempo determinato | FT | 131 | 0.296 | 1.072 |
| Tempo indeterminato | FT | 110 | 0.248 | 1.152 |
| Tempo determinato | PT | 48 | 0.108 | 1.060 |
| Somministrazione | FT | 39 | 0.088 | 0.905 |
| Tempo indeterminato | PT | 34 | 0.077 | 0.935 |
| Intermittente | PT | 19 | 0.043 | 0.741 |
| Apprendistato | FT | 18 | 0.041 | 0.712 |
| Intermittente | FT | 14 | 0.032 | 0.974 |
| Apprendistato | PT | 11 | 0.025 | 1.186 |
| Somministrazione | PT | 11 | 0.025 | 0.630 |
| Domestico | FT | 4 | 0.009 | NA |
| Domestico | PT | 4 | 0.009 | NA |
quota_riga descrive la composizione contrattuale del
CCNL, quota_colonna il peso del CCNL entro la tipologia e
lq il ricorso del CCNL alla tipologia rispetto alla media
del gruppo; le regole sui totali e sul filtro ccnl sono
quelle della sezione precedente. Qui la soglia min_n agisce
sul totale della cella tipologia x orario: nel dataset di esempio le
combinazioni meno frequenti restano sotto i 30 rapporti e mostrano
lq = NA. Con level = "codice" la dimensione è
il codice MLPS cod_tipologia_contrattuale con la
descrizione des_tipologia_contrattuale, mentre
orario = FALSE omette l’incrocio con l’orario e restituisce
una riga per CCNL e tipologia.
larga <- ccnl_by_tipologia(dt, measure = "n_rapporti", ccnl = top5, orario = FALSE)
knitr::kable(
  dcast(larga, ccnl_key ~ tipologia, value.var = "quota_riga", fill = 0),
  digits = 3
)| ccnl_key | Apprendistato | Domestico | Intermittente | Somministrazione | Tempo determinato | Tempo indeterminato |
|---|---|---|---|---|---|---|
| A011 | 0.065 | 0.018 | 0.074 | 0.113 | 0.404 | 0.325 |
| C011 | 0.065 | 0.014 | 0.058 | 0.167 | 0.333 | 0.362 |
| H011 | 0.086 | 0.023 | 0.070 | 0.156 | 0.375 | 0.289 |
| IC91 | 0.123 | 0.000 | 0.113 | 0.142 | 0.330 | 0.292 |
| T011 | 0.079 | 0.037 | 0.101 | 0.127 | 0.392 | 0.265 |
8. Retribuzioni dichiarate
Il campo retribuzione delle COB è la retribuzione annua
lorda dichiarata all’avviamento. Sui dati reali (diagnostica su 32
milioni di rapporti) il campo è affidabile dal 2020, contiene segnaposto
(0, 1, 100, 1.000, novi ripetuti) e, per i part-time, valori già
proporzionali alle ore dichiarate. Le tre funzioni seguenti ne tengono
conto: clean_retribuzione() classifica ogni valore senza
eliminare righe, normalize_fte() riporta i part-time
all’equivalente a tempo pieno, median_retribuzione()
calcola mediana e quartili ponderati per giornate per coorte di
avviamento.
La finestra di plausibilità è una regola mediana ± k·MAD
su scala logaritmica, calcolata per cella anno × macro-tipologia ×
orario con un pavimento sulla MAD (mad_min) e una cella di
ripiego quando la cella ha meno di min_n valori: i default
(min_valore = 100, max_valore = 1e6,
k = 4, mad_min = 0.15) derivano dalla
diagnostica sui dati reali.
clean_retribuzione(dt)
normalize_fte(dt)
riepilogo <- dt[, .(n = .N, quota = round(.N / nrow(dt), 3)), by = flag_retribuzione][order(-n)]
knitr::kable(riepilogo)| flag_retribuzione | n | quota |
|---|---|---|
| valida | 2139 | 0.731 |
| mancante | 735 | 0.251 |
| sentinella | 44 | 0.015 |
| fuori_range | 7 | 0.002 |
| zero | 2 | 0.001 |
| flag_fte | n | quota |
|---|---|---|
| full_time | 1441 | 0.492 |
| non_valida | 788 | 0.269 |
| riproporzionata | 680 | 0.232 |
| ore_mancanti | 18 | 0.006 |
normalize_fte() usa 40 ore di riferimento (con tabella
opzionale per CCNL o macro-tipologia, per esempio 54 per il lavoro
domestico) e moltiplica la retribuzione dei part-time per
ore_riferimento / ore; i part-time senza ore dichiarate
ricevono NA con flag ore_mancanti.
retribuzioni <- median_retribuzione(dt, periodo = "anno", ccnl = top5, min_n = 30)
knitr::kable(
  retribuzioni[, .(anno, ccnl_key, n, n_valide, copertura, giornate, p25, mediana, p75, var_pct, indice)],
  digits = c(0, 0, 0, 0, 2, 0, 0, 0, 0, 1, 1)
)| anno | ccnl_key | n | n_valide | copertura | giornate | p25 | mediana | p75 | var_pct | indice |
|---|---|---|---|---|---|---|---|---|---|---|
| 2022 | A011 | 155 | 119 | 0.77 | 28691 | 17123 | 20121 | 28371 | NA | 100.0 |
| 2023 | A011 | 137 | 105 | 0.77 | 21255 | 18339 | 22360 | 28020 | 11.1 | 111.1 |
| 2024 | A011 | 151 | 117 | 0.77 | 12756 | 18795 | 24088 | 30739 | 7.7 | 119.7 |
| 2022 | C011 | 48 | 36 | 0.75 | 8249 | 20984 | 27249 | 34163 | NA | 100.0 |
| 2023 | C011 | 57 | 44 | 0.77 | 7435 | 21921 | 28898 | 37489 | 6.1 | 106.1 |
| 2024 | C011 | 33 | 24 | 0.73 | 1610 | NA | NA | NA | NA | NA |
| 2022 | H011 | 78 | 56 | 0.72 | 12351 | 19593 | 21621 | 24492 | NA | 100.0 |
| 2023 | H011 | 92 | 64 | 0.70 | 11516 | 19787 | 26334 | 30655 | 21.8 | 121.8 |
| 2024 | H011 | 86 | 61 | 0.71 | 6793 | 20912 | 27116 | 29599 | 3.0 | 125.4 |
| 2022 | IC91 | 39 | 23 | 0.59 | 6313 | NA | NA | NA | NA | NA |
| 2023 | IC91 | 34 | 21 | 0.62 | 4283 | NA | NA | NA | NA | NA |
| 2024 | IC91 | 33 | 23 | 0.70 | 2648 | NA | NA | NA | NA | NA |
| 2022 | T011 | 60 | 48 | 0.80 | 13392 | 18385 | 21879 | 25547 | NA | 100.0 |
| 2023 | T011 | 65 | 44 | 0.68 | 8205 | 22324 | 26771 | 35131 | 22.4 | 122.4 |
| 2024 | T011 | 64 | 46 | 0.72 | 5793 | 21240 | 27062 | 35259 | 1.1 | 123.7 |
La mediana è ponderata per giornate (coerente con
longworkR); ogni riga riporta n,
n_valide e la copertura; le celle con meno di
min_n valori validi sono mascherate con NA ma
non eliminate. Per default entrano solo i rapporti avviati nella
finestra (solo_avviati = TRUE): le coorti precedenti sono
osservate solo se sopravvissute fino alla finestra. var_pct
è la variazione sul periodo precedente e indice pone a 100
il primo periodo non mascherato.
deflate_retribuzione() aggiunge le colonne
_reale a partire da un indice dei prezzi fornito
dall’utente (per esempio l’IPCA da istatlab) e da un
periodo base; qui l’indice è fittizio, a solo scopo illustrativo.
indice_illustrativo <- data.table(anno = 2022:2024, indice = c(100, 105.9, 107.1))
reali <- deflate_retribuzione(retribuzioni, indice = indice_illustrativo, base = 2024L)
knitr::kable(
  reali[ccnl_key == top5[1], .(anno, mediana, mediana_reale, var_pct, var_pct_reale, indice_reale)],
  digits = c(0, 0, 0, 1, 1, 1)
)| anno | mediana | mediana_reale | var_pct | var_pct_reale | indice_reale |
|---|---|---|---|---|---|
| 2022 | 20121 | 21550 | NA | NA | 100.0 |
| 2023 | 22360 | 22613 | 11.1 | 4.9 | 104.9 |
| 2024 | 24088 | 24088 | 7.7 | 6.5 | 111.8 |
9. Giornate effettive
giornate conta i giorni-contratto: una persona con due
rapporti concorrenti contribuisce due volte agli stessi giorni.
compute_giornate_effettive() ripartisce ogni giorno-persona
pro quota fra i rapporti concorrenti (1/arco), così che la
somma per persona coincida con i giorni effettivamente lavorati nella
finestra. La segmentazione usa punti di rottura a inizio e
fine + 1 con estremi inclusivi; i totali per persona
coincidono con sum(durata[arco > 0]) di
vecshift::vecshift(), che resta il riferimento
dell’ecosistema.
compute_giornate_effettive(dt)
attr(dt, "ccnlcob_giornate_effettive")[c("n_persone_sovrapposizioni", "giornate_totali", "giornate_effettive_totali")]
#> $n_persone_sovrapposizioni
#> [1] 297
#>
#> $giornate_totali
#> [1] 763201
#>
#> $giornate_effettive_totali
#> [1] 370941
per_persona <- dt[, .(giornate = sum(giornate), effettive = sum(giornate_effettive)), by = cf]
knitr::kable(head(per_persona[giornate > effettive][order(-giornate)], 5), digits = 1)| cf | giornate | effettive |
|---|---|---|
| CF00165 | 9714 | 1628 |
| CF00363 | 9261 | 1317 |
| CF00240 | 7388 | 1044 |
| CF00236 | 6635 | 1879 |
| CF00042 | 6086 | 1382 |
Con la colonna presente, rank_ccnl() accetta la misura
giornate_effettive: la quota di un CCNL molto usato in
rapporti concorrenti (per esempio intermittenti) scende rispetto a
giornate.
confronto <- rank_ccnl(dt, measures = c("giornate", "giornate_effettive"))
knitr::kable(
  head(confronto[, .(ccnl_key, giornate, quota_giornate, giornate_effettive, quota_giornate_effettive)], 8),
  digits = c(0, 0, 3, 0, 3)
)| ccnl_key | giornate | quota_giornate | giornate_effettive | quota_giornate_effettive |
|---|---|---|---|---|
| A011 | 118854 | 0.191 | 68794 | 0.185 |
| H011 | 62233 | 0.100 | 40231 | 0.108 |
| T011 | 49468 | 0.079 | 33103 | 0.089 |
| C011 | 31713 | 0.051 | 17555 | 0.047 |
| IC91 | 29904 | 0.048 | 20152 | 0.054 |
| A012 | 23667 | 0.038 | 12821 | 0.035 |
| B011 | 18770 | 0.030 | 13675 | 0.037 |
| E011 | 18163 | 0.029 | 10593 | 0.029 |
10. Analisi completa e serializzazione
analyze_ccnl() esegue l’intero flusso su una copia dei
dati grezzi e restituisce un oggetto ccnlcob_result con
metadati, passi eseguiti e saltati, ranking per finestra e per periodo,
CCNL rilevanti, distribuzioni per CPI e tipologia, retribuzioni (con
deflazione se si fornisce un indice) e una tabella di qualità per CCNL.
I blocchi opzionali non disponibili (per esempio il CPI senza lookup né
longworkR) vengono saltati e annotati, mai inventati.
res <- analyze_ccnl(
  cob_esempio,
  lookup_cpi = cpi_esempio,
  indice = data.table(anno = 2019:2024, indice = c(100, 99.8, 101.7, 110.0, 116.3, 117.5)),
  base = 2024L,
  top_n = 5
)
res
#> <ccnlcob_result>
#>   versione:                0.7.0
#>   as_of:                   2024-12-31
#>   window:                  2019-01-01 / 2024-12-31
#>   perimetro:               ccnl
#>   ccnl_key:                codice_cnel
#>   rapporti:                input 5.000, in finestra 4.746, avviati 4.746
#>   lavoratori avviati:      400
#>   copertura codice CCNL:   83,7%
#>   copertura retribuzione:  73,2%
#>   CCNL rilevanti:          5 (misura: giornate)
#>   primi CCNL:
#>      1. A011     19,5%
#>      2. H011     9,7%
#>      3. T011     8,3%
#>      4. IC91     4,9%
#>      5. C011     4,8%
names(res)
#> [1] "meta"            "ranking"         "ranking_periodo" "rilevanti"
#> [5] "keys"            "cpi"             "tipologie"       "retribuzioni"
#> [9] "qualita"
knitr::kable(res$qualita[order(-n_rapporti)][1:6], digits = 3)| ccnl_key | n | n_rapporti | quota_troncata | copertura_retribuzione | copertura_ore | copertura_cpi |
|---|---|---|---|---|---|---|
| A011 | 904 | 904 | 0.121 | 0.756 | 0.988 | 0.951 |
| NA | 775 | 775 | 0.142 | 0.706 | 0.968 | 0.942 |
| H011 | 504 | 504 | 0.141 | 0.724 | 0.972 | 0.946 |
| T011 | 354 | 354 | 0.147 | 0.734 | 0.962 | 0.972 |
| C011 | 257 | 257 | 0.113 | 0.739 | 0.987 | 0.942 |
| IC91 | 216 | 216 | 0.125 | 0.708 | 0.951 | 0.954 |
L’indice dei prezzi qui è fittizio, a solo scopo illustrativo.
write_results() serializza il risultato secondo il
contratto di uscita: tabelle piccole in RDS, cubi in FST (compressione
85, con gli attributi conservati in meta).
cartella <- file.path(tempdir(), "ccnl_output")
manifesto <- write_results(res, cartella, overwrite = TRUE)
knitr::kable(manifesto[, .(oggetto, formato, righe)])| oggetto | formato | righe |
|---|---|---|
| meta | rds | NA |
| ranking | rds | 25 |
| ranking_periodo | rds | 150 |
| rilevanti | rds | 7 |
| keys | rds | NA |
| cpi | fst | 65 |
| tipologie | fst | 58 |
| retribuzioni | rds | 30 |
| qualita | rds | 25 |
11. Grafici
Le funzioni grafiche sono opzionali (richiedono ggplot2,
in Suggests) e restituiscono oggetti ggplot senza
stamparli. Usano la palette Okabe-Ito e codifiche ridondanti (ordine,
etichette dirette, tipo di linea e forma dei punti), così che
l’informazione non dipenda dal solo colore; il quoziente di
localizzazione usa una scala divergente centrata su 1 e le celle
mascherate sotto min_n restano grigie.
plot_ranking(res, measure = "n_lavoratori", top_n = 8)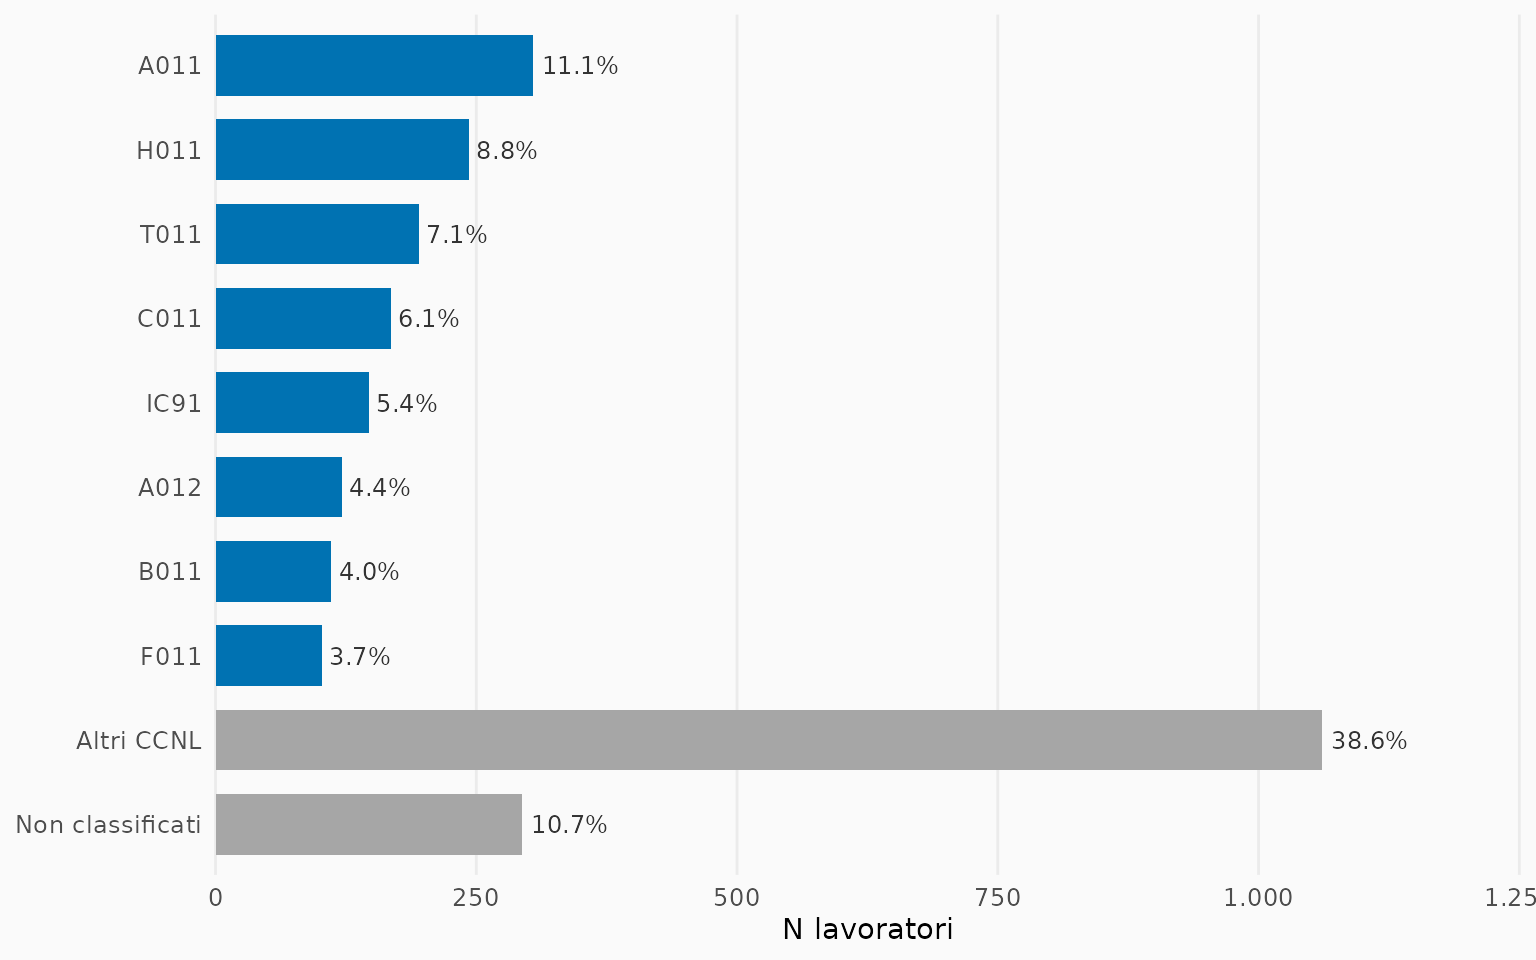
plot_cpi(res, value = "lq")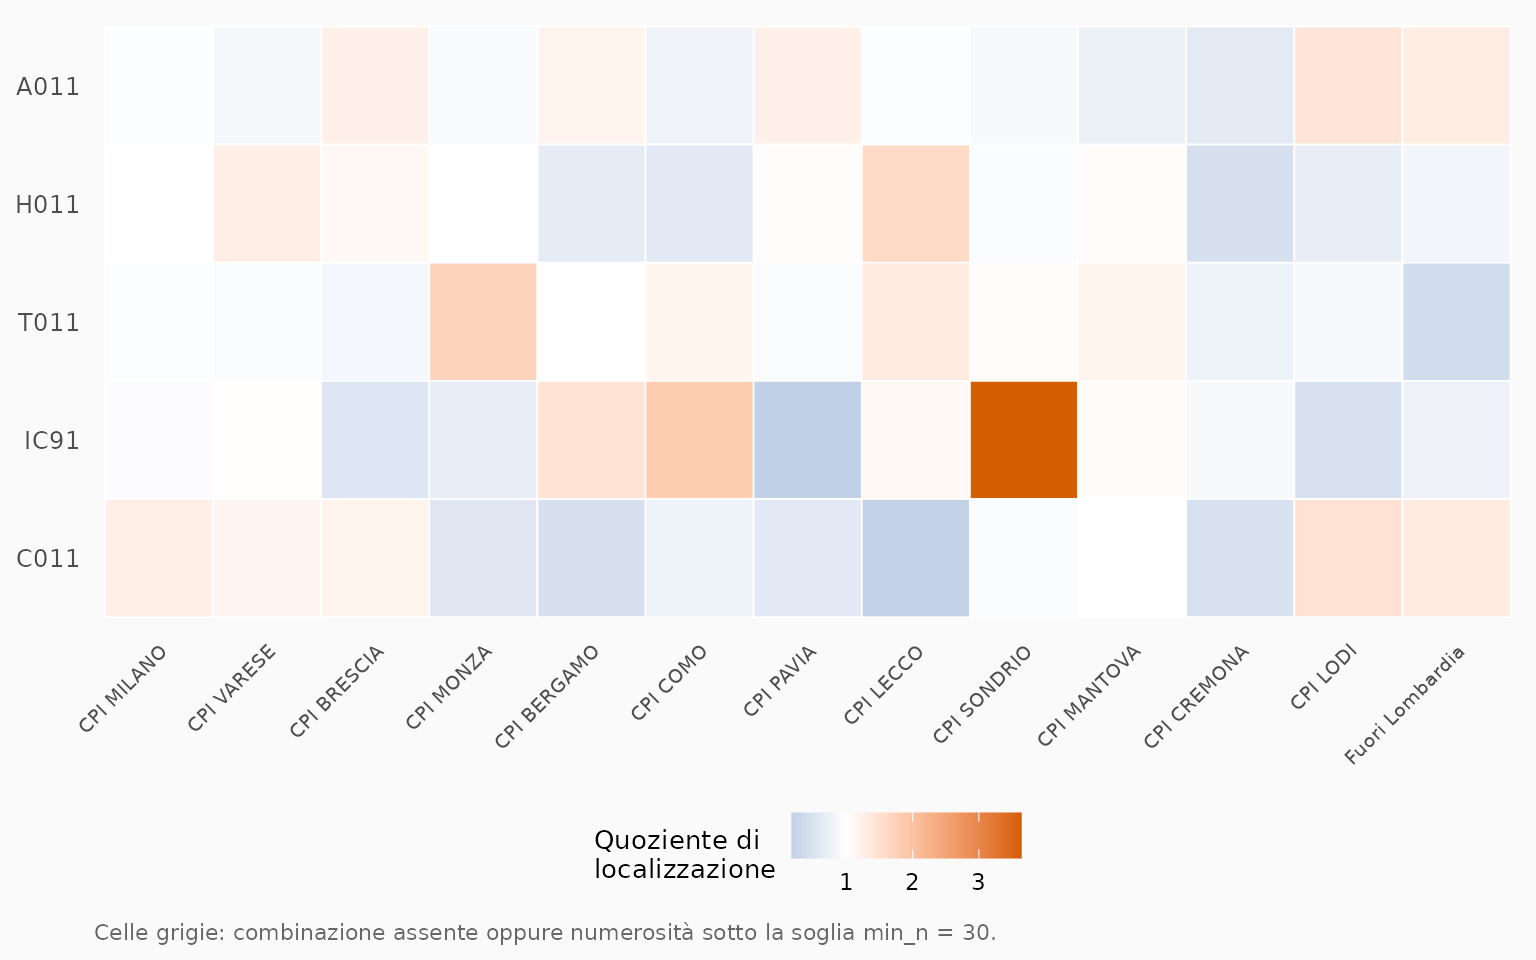
plot_retribuzioni(res, keys = res$keys[1:4], reale = TRUE)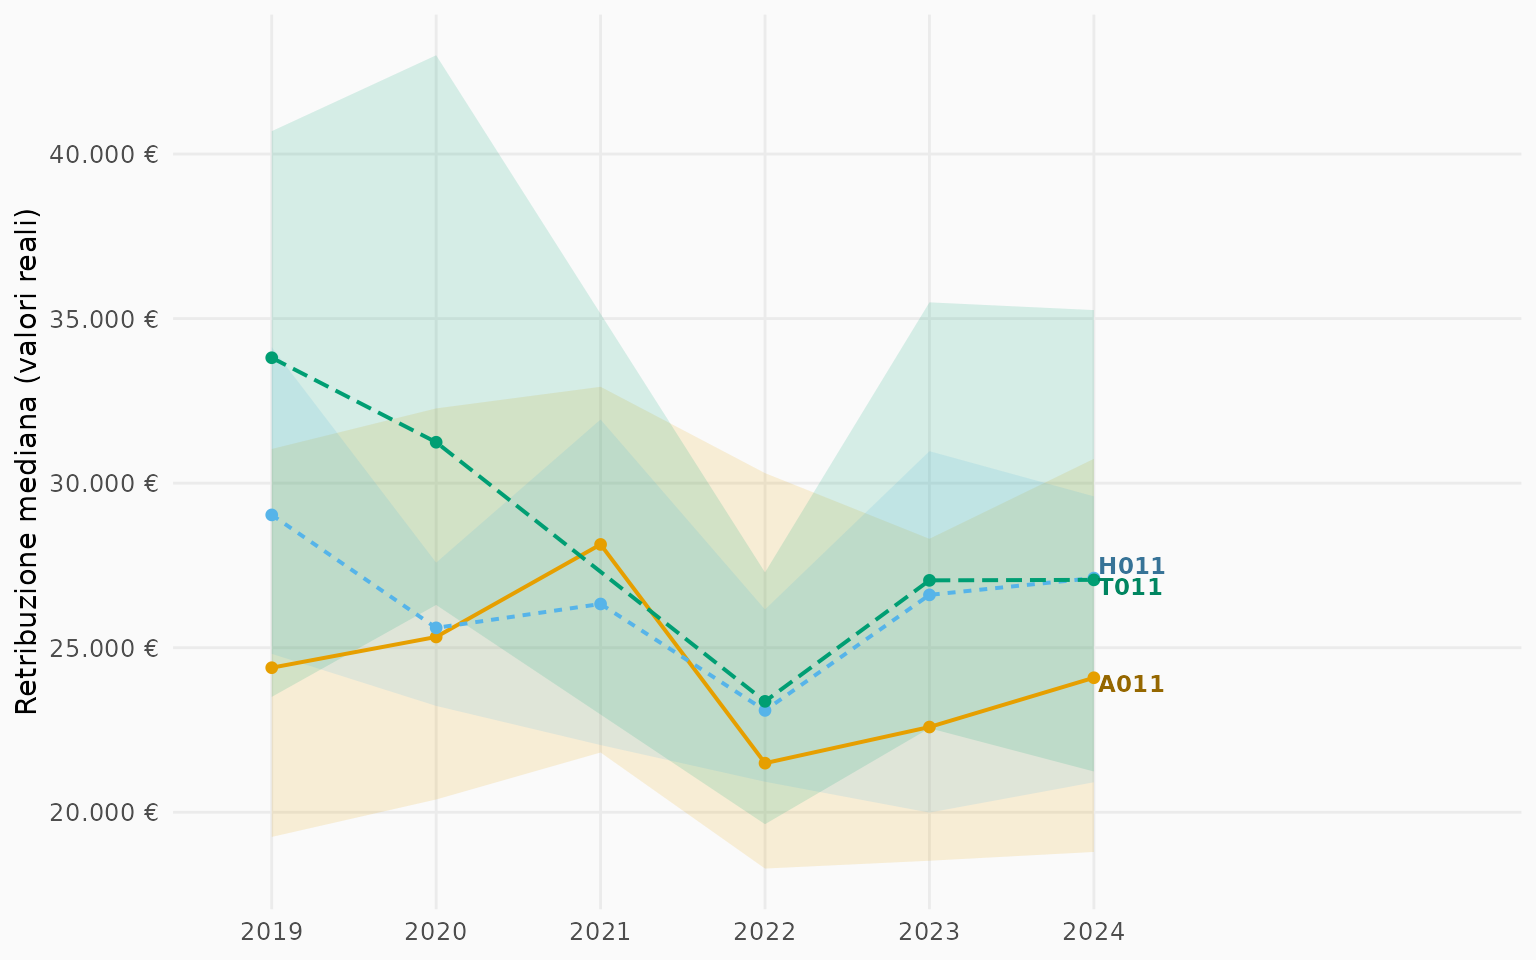
plot_ranking_periodo() e plot_tipologie()
completano la serie; render_report() compila il report
Quarto parametrico (inst/quarto/report_ccnl.qmd) sulla
cartella prodotta da write_results() e richiede Quarto
CLI.
12. Lettura dei rapporti da file e da database
read_rapporti() legge i rapporti da un file FST o RDS,
da un file DuckDB o da una connessione DBI, mappa i nomi del warehouse
al contratto dati (id_rapporto,
codice_fiscale_lavoratore,
codice_fiscale_datore, ore_settim_medie,
cod_qualifica_prof_istat_3dgt, sesso_lav,
eta_lav_inizio), deriva prior da
cod_tipo_orario e normalizza i tipi (factor,
integer64, testo numerico con eventuale virgola decimale).
Con una sorgente DB la selezione delle colonne e il filtro
where vengono spinti nella query.
percorso <- file.path(tempdir(), "rapporti_esempio.rds")
saveRDS(cob_esempio, percorso)
letti <- read_rapporti(percorso)
#> read_rapporti(): lette 5.000 righe da /tmp/Rtmph3mBu8/rapporti_esempio.rds.
attr(letti, "ccnlcob_source")[c("source", "n", "colonne_mappate")]
#> $source
#> [1] "/tmp/Rtmph3mBu8/rapporti_esempio.rds"
#>
#> $n
#> [1] 5000
#>
#> $colonne_mappate
#> named character(0)
La slice classificata da cnelR
(sl2_rapporti_36m_classificati) si legge così; il blocco
non viene eseguito nella vignetta.
dt <- read_rapporti(
  "~/data/cnel/rapporti_azure.duckdb",
  table = "sl2_rapporti_36m_classificati",
  where = "inizio >= DATE '2025-01-01'"
)
res <- analyze_ccnl(dt, as_of = "2026-04-30", top_n = 25)
Riferimenti
- Contratto dati in ingresso:
?validate_rapporti. - Regole sulle sentinelle e colonne derivate:
?prepare_rapporti. - Retribuzioni:
?clean_retribuzione,?normalize_fte,?median_retribuzione,?deflate_retribuzione. - Giornate effettive, analisi completa e serializzazione:
?compute_giornate_effettive,?analyze_ccnl,?write_results. - Lettura da file e database:
?read_rapporti. - Grafici e report:
?plot_ranking,?plot_cpi,?plot_retribuzioni,?render_report. - Perimetro contrattuale:
?filter_perimetro. - Misure e quote del ranking:
?rank_ccnl,?select_ccnl_rilevanti. - Mapping comune -> CPI e distribuzione territoriale:
?add_cpi,?ccnl_by_cpi. - Distribuzione per tipologia:
?ccnl_by_tipologia. - Lookup delle tipologie:
?tipologie_contrattuali. - Dataset sintetico e lookup CPI di esempio:
?cob_esempio,?cpi_esempio.